Archives de l’auteur : cezium

Les pointeurs intelligents

AymB9

Intro :

Les pointeurs intelligents sont une extension des pointeurs bruts et ont été inventés afin d’éviter les fuites de mémoire.

Explications :

Le principe est qu’un pointeur intelligent encapsule un pointeur brut : le pointeur habituel et le muni d’un système de libération automatique de la mémoire. Il suit le principe RAII.

C’est principalement autour de la notion de « durée de vie » qu’un pointeur tient son utilité. En effet le pointeur intelligent opère sur les actions de création, de copie, de destruction, etc… d’un objet.

Dans la version du C++11 il existe trois types différents de pointeurs intelligents.

– unique_ptr, le pointeur ne peut pas être partagé (il ne peut y avoir qu’un seul propriétaire).
Il est préférable d’utiliser ce type de pointeur plutôt que l’ancien type de pointeur (d’avant C++11) : auto_ptr. En effet auto_ptr ne dispose pas d’un système de protection de la copie !

– shared_ptr, le pointeur peut être partagée par un système de comptage de référence.

L’idée est qu’un pointeur intelligent est automatiquement détruit lorsqu’il sort de portée du bout de code.

Voici les opérateurs surchargés d’un pointeur intelligent :


Exemple :

Une fonction retournant un pointeur : une fois retourné on ne sait pas où, quand et comment libérer la mémoire allouée par ce pointeur !


Mais depuis C++11, on peut utiliser un type le pointeur intelligent nommé unique_ptr comme suit :


Il sera détruit automatiquement à la fin de la portée du bloc de code ! Comme le pointeur brut est encapsulé dans l’objet unique_ptr<> : il sera aussi détruit avec. Une de ses particularité est qu’il a toujours un unique propriétaire. Mais la fonction std::move permet d’échanger celui-ci.

Un autre type de pointeur intelligent est le shared_ptr, il peut y être adjoint plusieurs références. Lorsque la dernière référence est disjointe, le pointeur est détruit !


Pour finir, il est important de noter que l’on peut créer un objet sur le tas en utilisant std::unique_ptr !!

Résumé :

Nous avons présenté le concept et les objets des pointeurs intelligents du C++11 !

Références :

– https://msdn.microsoft.com/fr-fr/library/hh279674.aspx

– http://en.wikipedia.org/wiki/Smart_pointer

– http://www.informit.com/articles/article.aspx?p=2085179
Debugguez vos fichiers .FX avec l’interface ID3D10Blob

AMD_6990

Intro :

Quand on compile un effet shader .fx, on a besoin de savoir où se situe l’erreur de compilation lorsque la compilation a échouée.

Explications :

Voici comment procéder avec le bout de code suivant :


Résumé :

On a expliqué comment procéder pour savoir et afficher où se situe l’erreur de compilation d’un fichier shader .fx.

Théorie sur les lumières

light

Intro :

Dans les jeux vidéo, la gestion du rendu des lumières est cruciale pour effectuer un rendu à la fois réaliste et joli.

Dans cet article nous allons présenter les rudiments de la théorie sur le rendu des lumières.

Le rendu lumineux est un sujet vaste et complexe et pour cause le sujet est encore soumis à des recherches académiques ou en R&D.

En effet, ces dernières années les jeux vidéos les plus récents affichent des rendus de lumière de plus en plus réalistes, en utilisant par exemple un type de rendu nommé Deferred Shading.

[éclater en plusieurs articles]

Prérequis : 

– Savoir ce qu’est une normale

– Savoir lire du C++

– Savoir lire un programme shader HLSL

Explications :

Avant tout, éclaircissons un peu de vocabulaire.

Les deux notions qui suivent ont des propriétés de nature différente :

Les propriétés d’un matériau donnée (or, glace, bois, métal, etc…) déterminent comment un modèle est affiché :

– Emissive :

– ce terme désigne la valeur d’émission d’un matériau permettant d’émettre une couleur de lumière comme si elles avaient été toutes désactivées. Notée Ke.

– Ambient :

– ce terme désigne la valeur ambiante d’émission d’une lumière, comme le soleil.

– Diffuse :

– ce terme désigne la couleur diffuse qu’émet la lumière dans toutes les directions.

– Specular :

– Specular power :

– représente le degré d’éclat de brillance.

Les propriétés d’une lumière donnée déterminent comment la scène est affichée :

– Type de lumière :

– il y a 3 types de lumière :

Point : une lumière qui émet dans toutes les directions.

Spot : une lumière qui émet dans une direction spécifique.

Directional : une lumière qui a une direction donnée mais n’a pas de position donnée, comme par exemple le soleil.

– Color :

– la couleur de la source de lumière

– Position :

– définie la position de la lumière par trois valeurs de coordonnées

–  Direction :

– définie la direction à laquelle pointe la lumière

Le but du calcul lumineux est de combiner ces deux catégories de propriétés afin déterminer la couleur finale de la lumière (avec ses nuances d’ombre).

Lumière ambiante :

La lumière ambiante désigne, comme son nom l’indique, une lumière qui éclaire dans toutes les directions. C’est comme un soleil qui illumine partout.

L’équation est toute simple :

Ip = pa  * Ia 

[utiliser ambient = Ka + Ga]

Ia désigne l’intensité de la lumière ; et pa le coefficient de réflexion de la lumière ambiante. Ip désigne l’intensité de la lumière résultant de la réflexion sur la surface finale.

Ce principe de calcul de la lumière illuminative est très rudimentaire car il n’affiche pas les ombres des modèles que font apparaître indirectement la lumière émissive.

[image lumière ambiante]

La réflexion diffuse :

Le principe de la réflexion diffuse consiste à considérer la position d’émission d’une lumière quelconque (ou plusieurs)

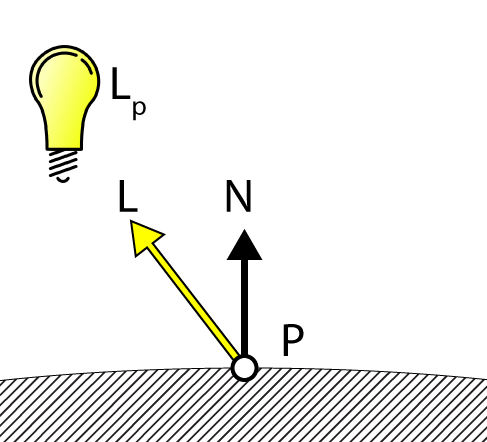
On a remarqué, mathématiquement, que l’intensité en un point de l’effet d’une lumière quelconque dépend de l’angle formé entre le rayon de lumière qui touche le point de la surface et la normale à la surface.

Il se trouve que, plus l’angle formé entre le rayon de lumière et la normale au plan est faible, plus l’intensité lumineuse réfléchie visible par l’observateur est forte.

[ajouter schéma dot product]

Diffuse-Lighting

Types de calcul lumineux :


Résumé :

Références :

– http://irrlicht-fr.org/lire_tuto.php?id=1014

–  https://takinginitiative.wordpress.com/2010/08/30/directx-10-tutorial-8-lighting-theory-and-hlsl/

– http://www.3dgep.com/texturing-lighting-directx-11/

– http://http.developer.nvidia.com/CgTutorial/cg_tutorial_chapter05.html

Nouveautés C++11

5146902896965.jpg

Intro :

Des changements ont été ajoutés dans la nouvelle version du C++ (nommée C++11).

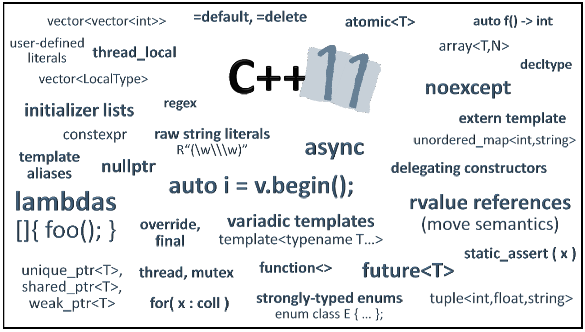
Tous les mots-clés en liaison avec les changements sont représentés dans l’image de l’en-tête.

Explications :

Le mot-clé / constante nullptr :

– Il remplace l’ancien « #define NULL 0  » pour définir un pointeur nul.

Le mot-clé auto :

– Il identifie automatiquement le type de la variable correspondante en fonction de l’affectation décrite. Il permet de simplifier l’écriture du code.

Exemple :


decltype :

– Permet de retrouver le type de l’objet lorsque l’on a utilisé le mot-clé auto.

Variadic templates :

– Permet d’utiliser un nombre variable de spécifications de classe sur les templates.

unique_ptr<> :

– Un pointeur intelligent possédant qu’un seul (et unique) propriétaire !

Initialisation des données membres non-statique :

– Les variables membres non-statiques peuvent être définit au sein même de la déclaration de la classe.


Alias de templates :

– On peut désormais utiliser le mot-clé « using » pour faire un alias à la place du classique typedef

Constructeurs délégués :

– Avec le C++11, un constructeur peut appeler un autre constructeur directement.


Range-based for :

– On peut parcourir un tableau, une liste, un vector, etc… avec une boucle simplifiée :


Les fonctions lambda : 

– La syntaxe est : [ liste de capture ] ( paramètres ) retour { code }

Exemple :

On peut passer une fonction anonyme à une variable :


Les énumérations fortement typées :

Dorénavant les numérations peuvent être fortement typées ainsi :


Bug template corrigé :


Les listes d’initialisateurs :


Les tableaux à taille fixe :


Tuple :

Mémoire locale pour un thread :

– Avec le mot-clé std::thread_local, on peut spécifier une variable locale à un thread !

Sizeof sur les attributs de classes :

– On peut désormais savoir la taille qu’occupe un attribut d’une classe.

Références :

– http://cpp.developpez.com/redaction/data/pages/users/gbdivers/cpp11/

– http://fr.wikipedia.org/wiki/C%2B%2B11

– http://openclassrooms.com/courses/introduction-a-c-2011-c-0x

Mettre en surbrillance l’icone de la barre des tâches

barre

Intro :

Parfois on a besoin de captiver l’attention du joueur lorsque l’application est minimisée, par exemple lorsque le joueur reçoit un message depuis la messagerie.

Pour cela l’icône dans la barre des tâches peut être mise en surbrillance lorsque l’application est minimisée.

Prérequis :

– Aucun

Explications :

Résumé :

Nous avons appris comment mettre en surbrillance l’icône de votre application dans la barre des tâches.

Fonctions delegates avec std::function et std::bind


5146902896965.jpg

Intro :

Nous allons implémenter un système de delegates comme celles existantes en C#.

Tout d’abord qu’est-ce qu’une fonction anonyme (appelée aussi fonction lambda) ?
Une fonction anonyme est tout simplement une fonction qui n’a pas de nom et qui peut être définie à la volée.

Depuis la dernière version C++11 on peut définir des fonctions anonymes.

Dans ce tutoriel nous allons apprendre à utiliser deux objets de la STL que sont : std::function et std::bind.

A noter que je me suis servi de ces delegates pour implémenter le système d’Events de cet article.

Prérequis :

– Savoir un peu lire du C++.

– Disposer d’un compilateur compatible C++11.

Explications :

Une fonction anonyme peut être définie ainsi :

On place des crochets au début pour annoncer une fonction lambda.
Entre parenthèses on indique les paramètres.
Le type indiqué juste après la flèche indique le type de retour de la fonction.


L’objet std::function peut être affecté par une simple fonction ou par une fonction anonyme :

On met entre crochets : le type de retour et le type des paramètres entre parenthèses.


L’objet std::bind permet de lier un ou plusieurs paramètres de manière préétablis à un objet std::function :


On peut faire spécifier ultérieurement un paramètre avec std::placeholder::_* :


On peut stocker des std::function dans un std::vector :


Résumé :

Nous avons appris comment définir des fonctions delegates comme celle disponibles en C#.

Références :

– http://fr.cppreference.com/w/cpp/utility/functional/function

– http://fr.cppreference.com/w/cpp/utility/functional/bind

– http://oopscenities.net/2012/02/24/c11-stdfunction-and-stdbind/

– http://openclassrooms.com/courses/introduction-a-c-2011-c-0x

Un Performance Timer pour synchroniser vos entités

timer-image

Intro :

Dans un jeu, il peut être utile de calculer le temps entre chaque affichage pour synchroniser la mise à jour de certaines entités.

En effet la vitesse de calcul fait par votre processeur peut rendre la vitesse de ces entités trop rapide.

Par exemple la vitesse de déplacement d’un modèle peut être plus rapide sur la machine d’un PC avec un processeur plus rapide que le vôtre, parce que la boucle de rendu est appelée plus fréquemment que chez vous.

Un mécanisme de calcul du temps passé entre chaque rendu d’affichage permet de pallier ce problème.

Prérequis :

– Savoir lire du C++.

Explications :

Nous allons utiliser la fonction QueryPerformanceCounter qui donne le temps présent en « count ».

On fait la soustraction : B – A, et on a le temps passé (en count) entre l’exécution de ces instructions !

D’autre part il nous faut le temps en seconde (et non en count !)

Dond avec la fonction QueryPerformanceFrequency on obtient le count par seconde.
On aura donc le temps escompté en seconde !


Le nombre de secondes escompté en un count est calculé par :


Temps passé entre chaque affichage :

On peut calculer le temps passé entre chaque rendu d’affichage. Notons t le temps passé ;
et \(t _{i} \) le temps passé depuis le ième affichage et \(t _{i-1} \) le temps passé depuis le précédent affichage.

\(\Delta t = t _{i} { – } t_{i-1} \)


On calcule ainsi le temps passé entre chaque affichage. On utilise cette valeur de temps afin de synchroniser la mise à jour de nos entités dans la boucle de rendu :


Voici un exemple de mise à jour d’une entité en utilisant la valeur fTimeSinceLastFrame (toujours changeante) :


Résumé :

Nous avons vu de quelle façon synchroniser la mise à jour de vos entités de façon à ce qu’elles varient dans le temps à la même vitesse sur toutes les machines.

Génération procédurale d’un labyrinthe 3D

laby

Intro :

La génération procédurale d’un contenu par un quelconque algorithme permet de le créer de manière intelligente !

Dans cet article nous allons voir comment générer à la volée un labyrinthe en 3D.

Prérequis :

– Savoir lire du C++.

– Savoir ce qu’est un vertex buffer et un index buffer.

– Savoir manipuler un tableau à deux dimensions.

Explications :

Nous allons utiliser une classe Array2D qui nous permettra de manipuler un tableau à deux dimensions.

Voilà le code pour ce tableau spécial et simple d’utilisation (Array2D.h) :

Voici le fichier d’en-tête MazeGenerator.h

Références :

– http://www.mazeworks.com/mazegen/mazetut/

RAII (Resource Acquisition Is Initialization)

02_clipmaps_02

Intro :

Parfois on a besoin simplement d’utiliser une variable ou un objet de manière temporaire, pour ensuite le ou la détruire facilement après son utilisation.

En C++, les objets résidant sur la pile sont automatiquement détruits lors de la sortie d’un bloc de portée, y compris dans le cas d’une levée d’exception ; leur destructeur est appelé avant que l’exception ne se propage.

On peut alors se servir de ce mécanisme pour détruire automatiquement un objet une fois effectué son utilisation.

Prérequis :

– Avoir quelques notions de C++

Explications :

Il s’agit de manipuler un objet local qui sera utilisé dans la portée d’un bout de code et qui sera ensuite libérée lors de sa destruction.

Système de profiling :

Exemple :


Résumé :

Nous avons présenté le principe du RAII. Ce principe permet de simplifier les initialisation du constructeur d’un objet, sans avoir à appeler le destructeur.

Récapitulatif C++

C++-unofficial.sh-600x600

Intro :

Le langage C++ est le langage le plus utilisé dans le monde du développement de jeu-vidéo.

Ce petit tutoriel à pour but de vous faire réviser certaines notions de C++.

Prérequis :

– Avoir quelques notions de C++

Explications :

Le C++ est un langage orienté objet. C’est-à-dire que l’on manipule des objets en déclarant des classes au sein du code.

Qu’est-ce qu’une déclaration de fonction / classe ?

Une déclaration indique l’identificateur d’une variable et sa nature (c’est-à-dire respectivement son nom et sa nature).

Qu’est-ce qu’une définition de fonction / classe ?

Une définition implémente la structure d’une fonction ou d’une classe afin de pouvoir l’utiliser.

Commentaires :

Qu’est-ce qu’une classe ?

Une classe permet de regrouper dans une même entité des données et des fonctions membres (appelées aussi méthodes) permettant de manipuler ces données.

Créer un objet à partir d’une classe :

Les opérateurs new et delete permettent de créer un objet en allouant sa quantité de mémoire.
A chaque new doit correspondre un delete, sinon il risque d’avoir une fuite de mémoire (memory leak) !
L’opérateur delete appelle le constructeur à détruire de la classe.

Qu’est-ce qu’un objet ?

Un objet est l’instance d’une certaine classe.

L’héritage :

En C++, les classes peuvent hériter d’autres classes et la relation d’héritage est exprimée à l’aide de l’opérateur de dérivation « : ».

L’encapsulation :

– les déclarations en dessous de « public: » seront accessibles depuis n’importe quelle fonction.
– en dessous de « protected: » : pareil que private mais accessible depuis les classes
filles.
– en dessous de « private: » : accessible que depuis les fonctions de la classes.

L’opérateur sizeof :

Sert à calculer la taille de n’importe quel type de données.
On note que sizeof(char) = 1.

sizeof(x) = 1 ssi x est un byte. (Un byte est la plus petite unité adressable d’un ordinateur)

Opérateurs d’entrées-sorties :

On peut écrire dans la console avec l’instruction suivante :

On peut écrire du code UTF-8 aussi :

Les pointeurs :

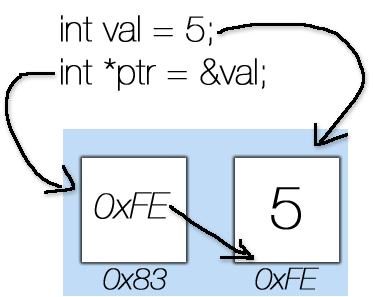
Un pointeur désigne une adresse d’une variable d’un certain type.

Le références :

Une référence peut être vue comme un alias d’une variable. C’est un « synonyme » d’une autre variable. Une modification de l’une modifiera l’autre.

Valeur par défaut des paramètres d’une fonction :

Fonctions inline :

Les fonction inline fonctionnent comme les macros.

Surcharge de fonctions :

Tas et Pile :

Tas :

Pile :

Instanciation d’une classe :

Fonctions membres statiques :

– existent même s’il n’y a aucune instance de classe.

– ne peuvent accéder qu’aux membres statiques de la classe.

Exceptions :

Moyen de gérer les erreurs dans un programme C++.

Caméra à la 3ème personne trigonométrique

caméra

Intro :

Pour se déplacer dans la scène 3D il faut mouvoir une caméra.

Dans cet article nous allons implémenter une caméra qui tourne autour d’un joueur (ou autour d’une position)

Prérequis :

– Comprendre un minimum de notions trigonométriques

Explications :

Déclarer ces trois variables dans un fichier quelconque :


Voilà les fonctions d’initialisation et de mise à jour de la caméra à la 3ème personne :

Résumé :

Nous avons présenté un moyen d’implémenter une caméra trigonométrique qui opère une révolution autour de la position du joueur !

Principe du Z-buffer

zbuffer

Intro :

L’utilisation du Z-buffer est une méthode consistant à afficher dans le bon ordre de profondeur les primitives géométriques envoyées au rendu 3D.

Prérequis :

– Comprendre les principales étapes de rendu de DirectX : voir cet article

Explications :

La technique du Z-buffer consiste à enregistrer pour chaque pixel une valeur de profondeur dans un tampon dédié (en l’occurrence le Z-buffer). Ce tampon a la même dimension que celui du frame buffer. Ces valeurs dans le tampon varient de 0.0f à 1.0f.

Lors de la transformation du repère 3D (celui des meshes / modèles) vers le repère 2D (celui de l’écran) nous avons bien les pixels sur les coordonnées (x, y) conservées mais nous avons perdu l’information sur la profondeur (z) ; il faut la recalculer par un algorithme adjacent.


1) Comment ça fonctionne ?

Avant qu’un pixel est affiché dans le tampon de rendu, sa valeur de profondeur est comparée
par sa valeur correspondante actuelle dans le Z-buffer. Si le pixel a sa valeur de profondeur inférieure ou égale alors le pixel est affiché et cette valeur est enregistrée dans le Z-buffer ; autrement le pixel est ignoré.

La carte graphique compare deux profondeurs (Z) une à une, et n’affiche que le pixel le plus proche de la caméra. Ensuite DirectX va automatiquement ignorer l’affichage des triangles cachés par d’autres triangles.

2) Comment le paramétrer ?

Le calcul effectué par le Z-buffer peut être ignoré et désactiver par un appel de l’API DirectX (voir cet article). Lorsqu’il est ignoré par DirectX, les derniers éléments dessinés seront affiché par dessus tous les autres.

Il faut noter aussi qu’à chaque tour de boucle le Z-buffer est réinitialisé et recalculé par cet appel :


Résumé :

Nous avons expliqué quel est le rôle du tampon de profondeur (le Z-buffer) dans le rendu 3D.
En effet cette étape permet de cacher les triangles placés à l’arrière d’autres triangles moins proches de la caméra.

Références :

– http://fr.wikipedia.org/wiki/Z-buffer

– http://www.toymaker.info/Games/html/z-buffer.html

Les principales fonctions de la bibliothèque D3DX (DirectX 10)

jigsawpuzzle

Intro :

La bibliothèque D3DX (D3DX utility library) implémente plusieurs fonctions courantes afin de faciliter certaines tâches d’utilisation de l’API 3D DirectX 10.

Nous verrons les objets de cette bibliothèque suivant :

– ID3DX10Sprite

– ID3DX10Font

– ID3DX10Mesh

Prérequis :

– Savoir comment initialiser correctement DirectX 10 (voir ces articles)

Explications :


ID3DX10Sprite :

Permet de simplifier l’affichage d’images 2D.

On créé cet objet avec la fonction : D3DX10CreateSprite()

J’ai déjà expliqué son utilisation dans cet article (dans la première méthode)


ID3DX10Font :

Permet d’afficher du texte à l’écran avec une police de font donnée.

On déclare les objets ID3DX10Font et ID3DX10Sprite :

On initialise plus loin ces objets comme suit :


Dans la boucle de rendu on ajoute :

Le paramètre D3DX10_SPRITE_SAVE_STATE permet de restaurer les états du rendu 3D après l’appel End() comme ils étaient configurés avant l’appel Begin().

On désactive l’écriture sur le Z-Buffer pour préserver la profondeur de ce qui est affiché avant l’appel à m_pFontText().


ID3DX10Mesh :


Bien configurer un projet Visual C++

index

[rajouter utf-8]

Intro :

Les débutants en C++ sous Windows ont souvent du mal à compiler leur premier programme.
En effet pour compiler un programme il faut indiquer au compilateur où chercher ses dépendances (répertoires de fichiers d’en-têtes et de bibliothèques)

Prérequis :

– Savoir un peu écrire et lire du C++

Explications :

1) Ouvrez votre projet C++

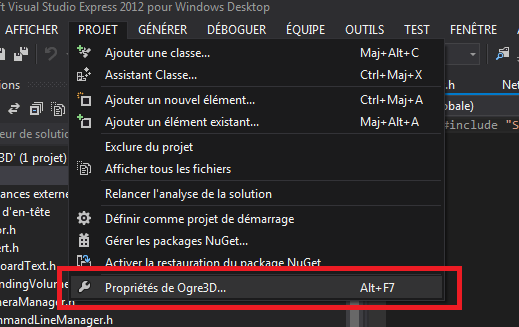
2) Allez dans les propriétés du projet (ALT+F7)

proprieties_2

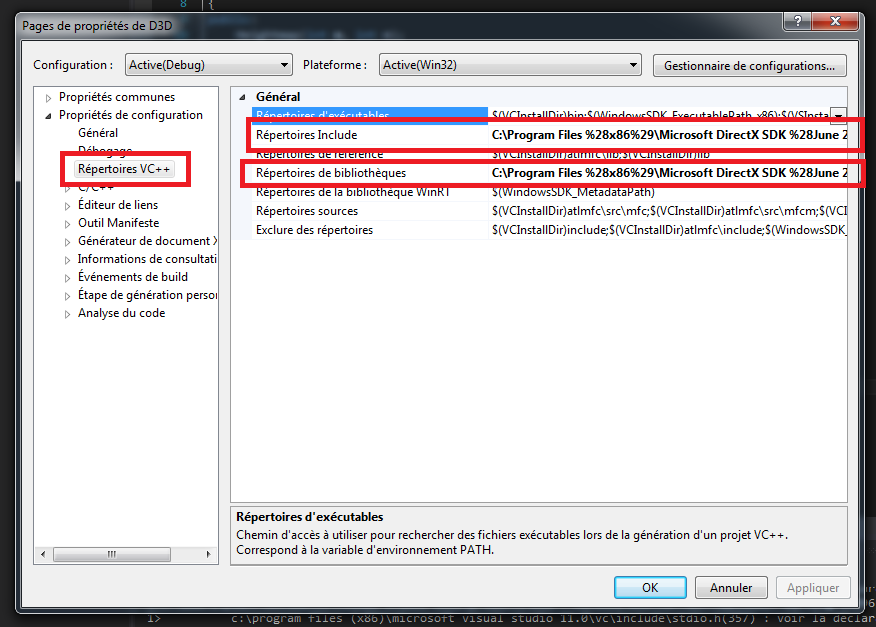
3) Allez dans la partie « Répertoires C++ »

repertoires_1

Vous verrez deux champs qui sont là pour indiquer où chercher vos fichiers #include et bibliothèques .lib des dépendances de votre projet.

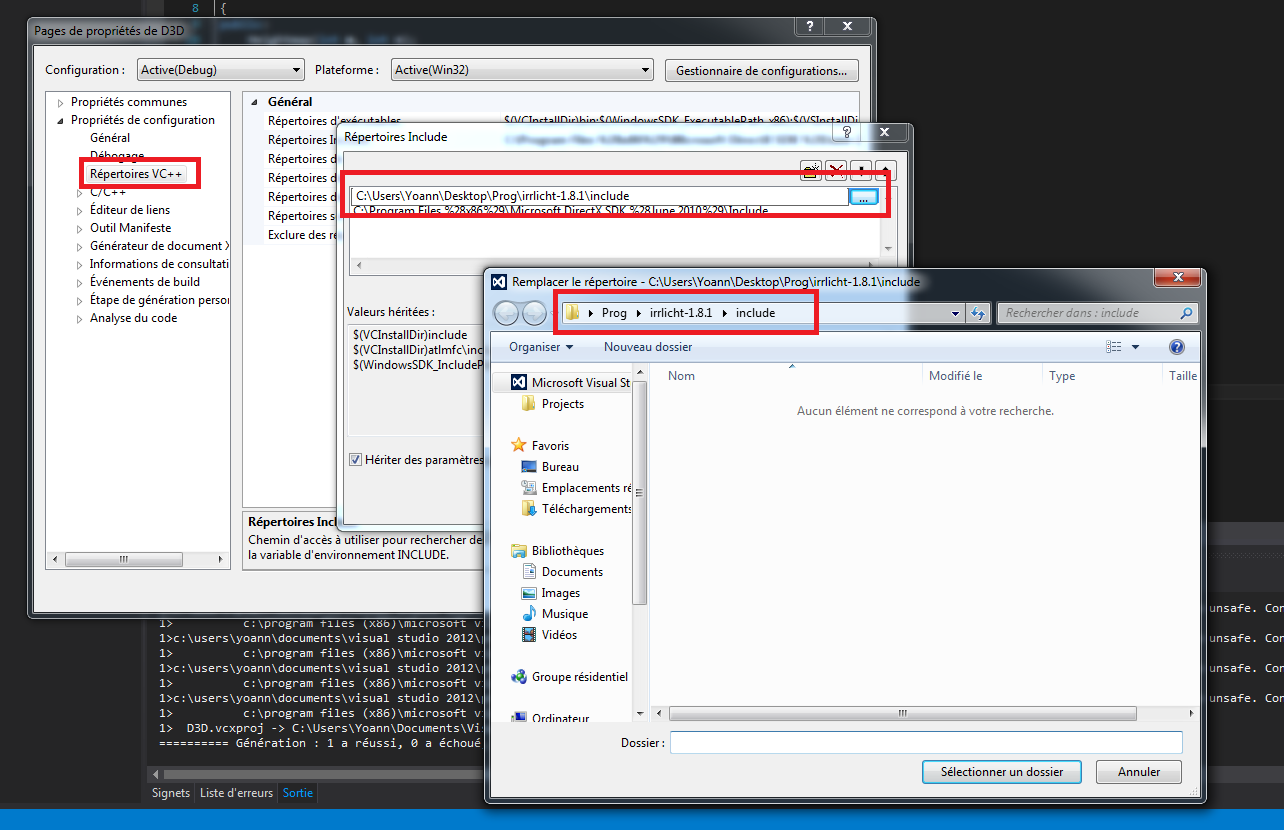
4) Il vous reste plus qu’à sélectionner le répertoire de votre dépendance !

repertoires_2

5) Compilez pour tester si votre projet est bien configuré !

 Résumé :

Dans cet article nous avons configuré Visual C++ de façon à ce qu’il trouve les dépendances externes à votre projet afin de le compiler sans erreurs apparentes.


Les fichiers d’en-têtes précompilés (Visual C++)

PrecompiledHeaders

Intro :

Parfois, étant donné le nombre faramineux de fichiers d’en-tête nécessaires pour compiler un fichier source .cpp, il peut etre nécessaire de tous les regrouper en seul fichier afin de le compiler en une seule fois.
Cette compilation accélère immédiatement la compilation des autres fichiers .cpp.

Prérequis :

– Savoir un peu lire du C++

Explications :

1) Ouvrez votre projet VC ++

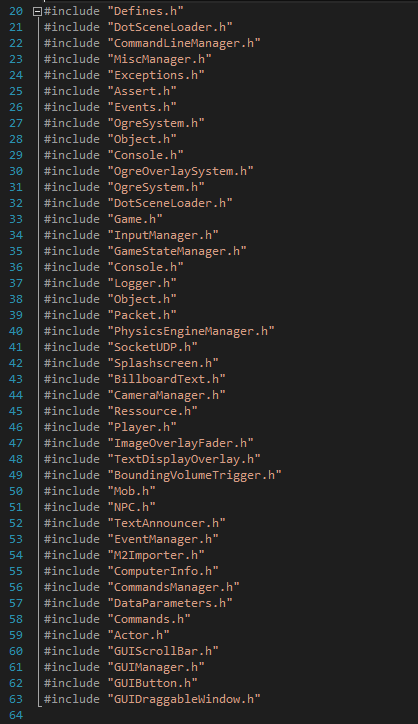
2) Créez un fichier Stdafx.h où vous mettrez tous vos fichiers .h les uns à la suite des autres (comme dans la première image).

3) Créez juste un fichier Stdafx.cpp où vous metterez :

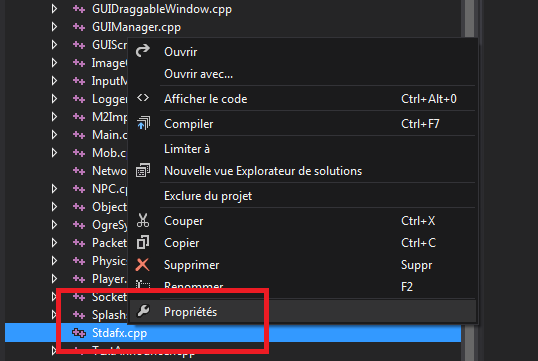
4) Faite un clic droit sur ce dernier fichier :

proprieties_4

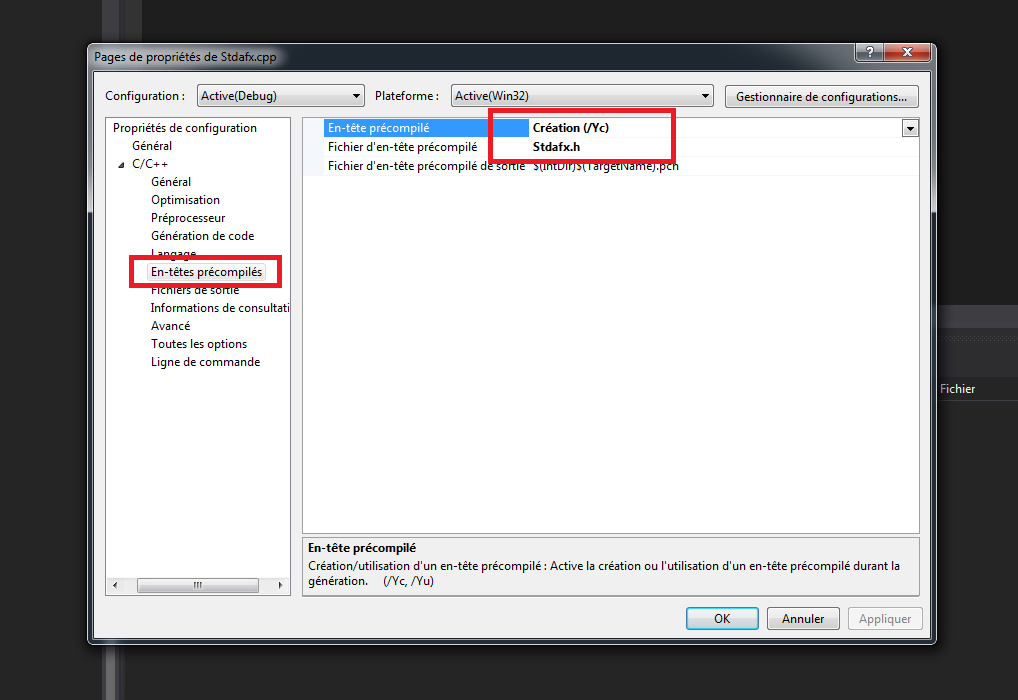
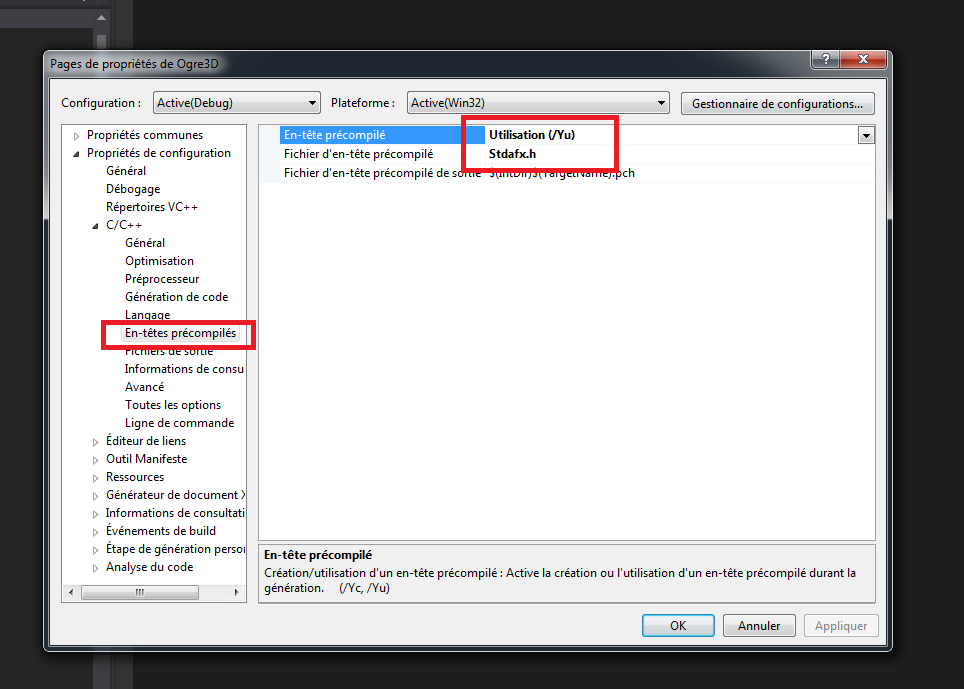
5) Allez dans la partie « En-tête précompilés ». Choisissez « Création /Yc » et ajouter comme dans l’image « Stdafx.h »

proprieties_5

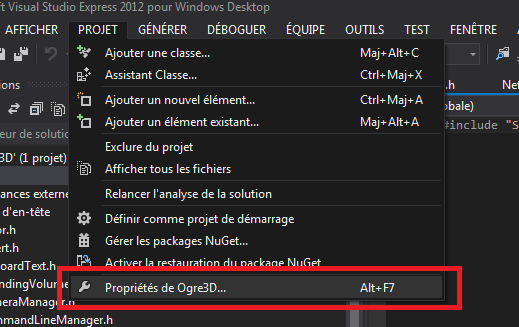
6) Ensuite allez dans les propriétés du projet (ALT+F7)

proprieties_2

7) Veillez à ce que « Stdafx.h » soit écrit et choisissez « Utilisation /Yu » :

proprieties

8) Dans le fichier Stdafx.h, vous pouvez mettre tous vos fichier #include :

9) Il reste plus qu’à mettre dans tous vos fichiers .cpp une seule en-tête :

10) Compilez et admirez la vitesse !

Résumé :

Nous avons appris comment regrouper un grand nombre de fichiers d’en-tête (des #include) en un seul fichier afin de rendre la compilation beaucoup plus rapide.

Introduction à la programmation réseau (Sockets) – partie 1

48405289

Intro :

Pour concevoir un jeu vidéo multijoueur il vous faut utiliser dans le programme C++ des objets qu’on appelle sockets. Ceci afin de pouvoir faire communiquer des ordinateurs à distance.

Prérequis :

– savoir un peu lire et écrire du C++

– être sous Windows.

Explications :

Les sockets sont des objets représentants une interface de connexion liée à une machine afin de faire communiquer les ordinateurs à travers un réseau (a fortiori par Internet)

1 – Tout d’abord je vais vous présenter un petit programme qui affiche une page HTML dans la console à partir d’une URL web en utilisant les sockets. Rien ne vaut un bel exemple concret pour comprendre !

2 – Aussi, comme il est important de connaître de quoi l’on parle, je vais énumérer toutes les fonctions et mots-clés utilisés dans la programmation socket en C.


1 – Voici ce premier programme :


Copiez / collez et compilez !


2 – Voici maintenant tous les principes, concepts et fonctions de la programmation de sockets :

Voici les fichiers d’en-tête nécessaires :


Voici les #define préétablis :


Voici la structure principale à utiliser :

Elle est utilisée pour configurer la socket.


Voici comment l’utiliser :

– sin.sin_addr.s_addr : c’est l’adresse qu’on affecte à cette configuration de socket (c’est peut-être l’adresse représentant un client ou un serveur, cela dépend du rôle de notre socket)

– INADDR_ANY : adresse IP automatique

Pour spécifier une adresse manuellement on peut utiliser la fonction inet_addr()

– sin.sin_family = AF_INET : spécifie que l’on passe la socket en mode Internet

– sin.sin_port : spécifie le numéro de port de la socket à utiliser

En occurrence, qu’est-ce qu’un port ?

Un port sert à spécifier à quel service d’application les informations doivent être envoyées.

En effet sur le réseau Internet global, chaque ordinateur est représenté par un numéro d’IP, mais cette adresse IP ne spécifie pas à quelle application de l’ordinateur l’information doit être envoyé.

En conséquence les applications / services sont identifiés par des numéros de port (ex : port 80 pour
le service HTTP)


Ces deux fonctions doivent être appelées pour initialiser ou clôturer l’utilisation des sockets :


Pour initialiser une socket :

Voici les différents paramètres de cette fonction :

Types de socket :

– Le protocole TCP est un protocole dit connecté. Il contrôle si le paquet
est arrivé à destination si ce n’est pas le cas il le renvoie.

– Le procotole UDP est un protocole dit non connecté. A l’inverse du protocole TCP
il ne contrôle pas si le paquet est arrivé à destination.


Cette fonction permet de convertir une addresse IP (en char*) afin d’être
affectée à la structure IN_ADDR.

Résumé :

Nous avons créé un programme qui affiche une page web afin de comprendre la programmation sockets.

Au final nous avons énuméré tous les concepts liés à la programmation sockets.

Références :

– http://pub.phyks.me/sdz/sdz/les-sockets.html

Intégration de Newton Dynamics dans Irrlicht 3D

physics

Intro :

Un moteur physique dans un jeu vidéo permet de simuler les phénomènes physiques du monde réél. Il fait bouger les objets dans le jeu par des mouvements réalistes.

Ici nous allons utiliser le moteur physique Newton Dynamics pour l’intégrer dans le moteur 3D Irrlicht.

Site web de Newton Dynamics : www.newtondynamics.com

Prérequis :

Savoir lire un peu du C++.

Explications :

Mettez dans un fichier PhysicsManager.h le code suivant :


Mettez dans un fichier PhysicsManager.cpp le code suivant :

Cette fonction s’occupe de lancer un cube dans la direction spécifiée.


La fonction suivante s’occupe de créer un objet Newton Body complètement statique et muni d’une collision solide.


La fonction suivante créée un objet collision englobant la forme du mesh passé en paramètre.


Les fonctions suivantes sont des callbacks (c’est-à-dire des fonctions appelées de manière
interne à Newton Dynamics).
La première sert à Irrlicht, elle permet de  savoir comment doivent être mis en mouvement les SceneNode enregistrées.
La deuxième indique à Newton comment doivent être configuré la pesanteur.


Cette fonction ajoute une MeshSceneNode au traitement de Newton Dynamics.
Elle fait appel à CreateCollisionFromMesh(…) pour créer l’objet de collision.
Elle s’occupe aussi de sauvegarder dans un fichier .cache les données de collisions. Cela permettra d’accélérer le calcul et le traitement de la structure de collision du Mesh si un fichier .cache à été trouvé.


Ces fonctions suivantes indiquent à Newton Dynamics comment charger ou sauvegarder
un fichier de collision .cache.


Voici les autres fonctions du fichier PhysicsManager.cpp :


Pour utiliser Newton dans Irrlicht, nous proposons le programme suivant :


Résumé :

Nous avons intégrer le moteur physique Newton Dynamics dans le moteur 3D Irrlicht.

Obtenir le taux d’occupation du CPU

cpu

Intro :

Dans cet article nous verrons comment obtenir le taux de consommation total du CPU de votre système et puis comment obtenir le taux de consommation du CPU du processus de votre application.

Pour info, j’ai déjà rédigé un article sur un sujet adjacent : les informations système.

Prérequis :

Savoir lire un peu du C++.

Explications :

Créez un fichier CPUTimer.h :


On accède aux pourcentages de consommation du CPU par le biais des fonctions :


Créez un fichier CPUTimer.cpp :


Résumé :

Dans cet article nous avons appris comment obtenir le taux d’occupation du CPU de votre système mais aussi de votre application !

Introduction à DirectX 10 – Rendu 2D – partie 5

directx9c

Intro :

Dans cette cinquième partie, nous allons apprendre comment afficher une image 2D à l’écran.
Nous proposerons deux façon d’implémenter cet affichage.

Prérequis :

Avoir suivi la cinquième partie de ce tutoriel.

Quatrième partie :

Afficher une image 2D à l’écran.

Explications (1ère façon plus simple, sans utiliser de shader) :

Voici le fichier Sprite2D.h :


Voici le constructeur de la classe Sprite2D :


Voici la méthode d’initialisation :


Voici les autres méthodes :


Explications (2ème façon plus compliquée, en utilisant un shader) :

Mettre dans un fichier Sprite2D.h :


Créer un fichier Sprite2D.cpp où vous metterez :


La fonction de rendu / d’affichage :


Ici la fonction de mise à jour de la position de l’image :


Créez un fichier Texture.fx, où vous mettrez :

Résumé :

Nous avons expliquées deux façon d’afficher du rendu 2D avec DirectX.

texture

Nous nous servirons de cet affichage 2D pour implémenter une UI (Interface Utilisateur).

Références :

– http://mscerts.programming4.us/programming/directx%2010%20game%20programming%20%20%20the%202d%20resurgence%20-%20sprites.aspx

Introduction à DirectX 10 – Lumière – partie 4

directx9c

Intro :

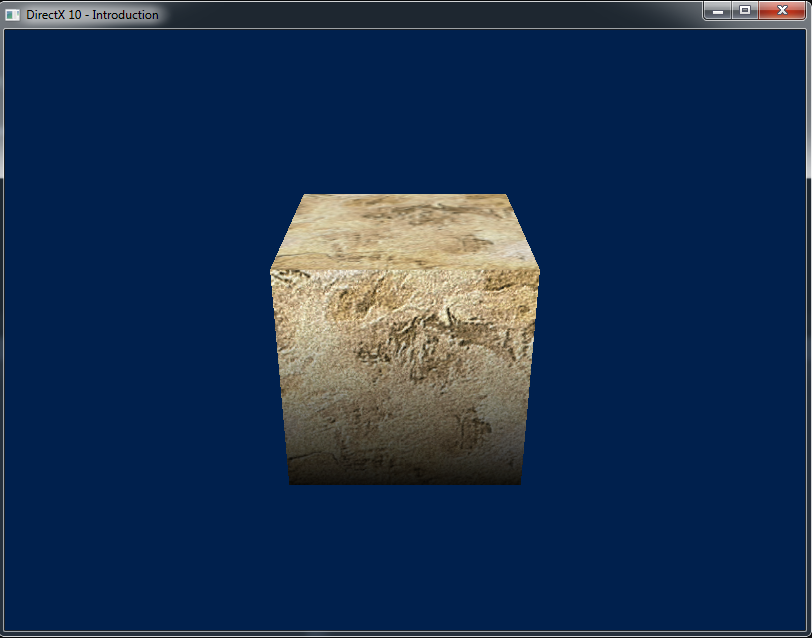
Dans cette quatrième partie, nous allons apprendre à intégrer une lumière afin d’éclairer notre cube.

Prérequis :

Avoir suivi la troisième partie de ce tutoriel.

Quatrième partie :

Afficher un petit cube éclairé d’une lumière.

Explications :

Nous allons utiliser cette structure de vertex :

Elle contient un attribut supplémentaire par rapport à la partie 3 : la normale.

La normale d’un vertex est un vecteur perpendiculaire à celui-ci ; nous l’utiliserons afin de calculer le degré de nuance de lumière à cet endroit.
C’est par ce principe que nous effectuerons globalement le calcul lumineux.

Voir cet article pour comprendre comment modéliser la lumière dans un rendu 3D.


Nous allons utiliser ce programme HLSL – partie4.fx :

Si vous ne comprenez rien à ce programme : consulter cet article.

Il faut aussi connaître la notion de matrices et le principe de transformations de coordonnées
pour comprendre ce code : voir cet article.


Dans votre fichier D3D10Renderer.h, rajoutez :

Ce sont les variables que l’on enverra au shader HLSL.


Ensuite dans votre fichier D3D10Renderer.cpp à la fonction Initialize(bool bFullScreen), rajoutez :


On créé le vertex buffer d’un cube : il est composé de la position, des coordonées de la texture et des normales de chaque vertex.

Les voici :


Toujours dans votre fichier D3D10Renderer.cpp à la fonction Initialize(bool bFullScreen), rajoutez :


Toujours dans votre fichier D3D10Renderer.cpp :

Résumé :

Nous avons intégré une lumière près de notre cube afin de l’éclairer.

partie4

Voici l’archive du code complet pour cette partie :  DirectX 10 Tutoriel – Partie 4.zip